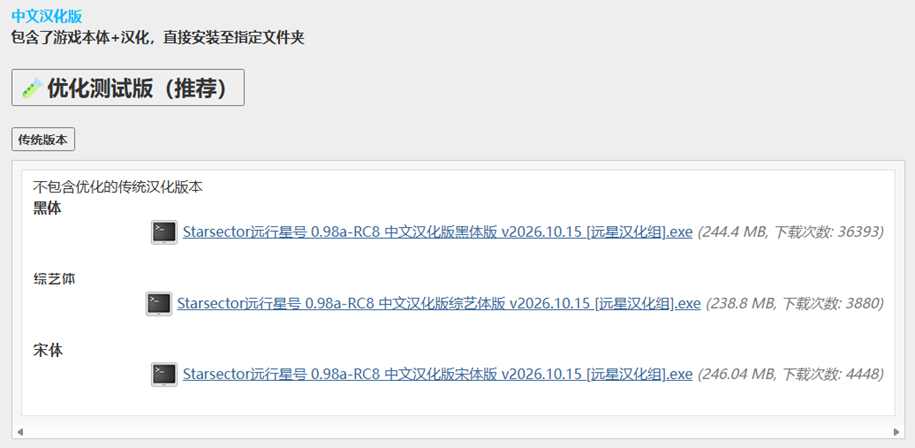
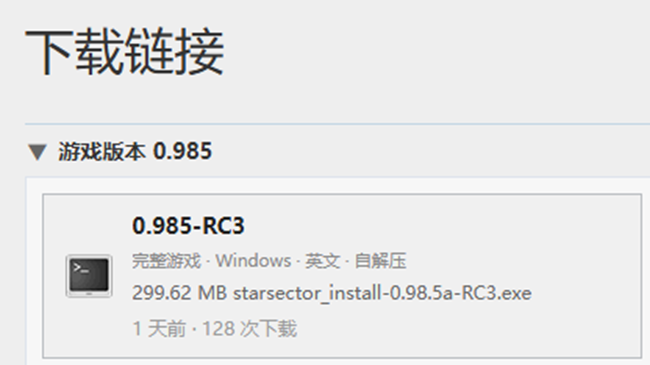
英文版用论坛最左侧的下载链接,右侧下载的内容我没弄明白是什么情况。
1.3 文件与环境清单
· 0.98a-RC8 中文汉化版(黑体):安装后保证能正常运行,用于取旧译文。
· 0.98.5a-RC3 英文版:安装后保证能正常运行,用于取原文与待改的 jar。
· 0.98 英文原版 starfarer_obf.jar:从 GitHub 下载后存成 源\starfarer_obf.en.jar(这里是dsh工作区文件夹地址,之后会进行详细解释),地址:
https://raw.githubusercontent.com/TruthOriginem/Starsector-Localization-CN/master/game%20data/starfarer_obf.jar
· JDK 21:需要 javac、jar、javap。
· Python 3.10 以上:工程里的脚本全部基于 Python。
· 工程目录:脚本、产出、源、备份四块,见第三节。
· 备份空间:不小于游戏目录的 2 倍。
· 文本编辑器与解压工具各一。
二、总体思路
先将是否存在已翻译内容作为第一判据,把文本分成两类:
· 类一:0.98已经译过、0.985 原文完全一致的部分。直接照搬,内容较多但难度不高。
· 类二:0.985纯新增、98 里没有的内容。没有旧译可抄,只能自行翻译。
再按文本存储地点分成三种载体,分别使用不同工具处理:
· data 目录的表格:csv、json、少量Java 数据,按 id 对齐,整格搬或按单元格替换。
· jar 里的字符串常量:改编译后的类文件常量池,只换「被String 常量引用」的那条 Utf8。
· 代码里拼出来的句子:变量、词形、人名地名混在一起,基本只能人工看(其实也是交给dsh处理)。
搬旧译的匹配判据只有一条:同一位置的原文,98 英文快照与 985 完全一致,且98 中文版这里是中文,才直接更换。任何一条不满足就不动,留给类二。
三、目录与约定
· 工程根:E:\SQ\小肥鲸管家\模组工程\汉化工程(各位请自行设置工作区,这里以帖主环境为例)。
· 产出\data:最终覆盖层,698 个文件。
· 产出\starfarer_obf.jar:6,135,400字节,3,916 处替换,涉及 580 个类。
· 产出\starfarer.api.jar:7,746,024字节,5,831 处替换,涉及 1,039 个类。
· 脚本:按编号的 Python 工具,从对照表、打补丁到校验都在里面。
· 源:0.98英文快照等参考资料;注意这份快照比正式发行版旧,不能拿它算「985 新增」。
· 源\starfarer_obf.en.jar:0.98英文原版 jar,和中文版逐类对照用。
· 源\Starsector-Localization-CN-master:汉化仓库源码,译文与数据层素材从这里取。
· 备份:每一步改动前的存档。
约定:所有改动只写 产出,不直接改游戏安装目录;要试玩时整包复制到测试目录(别在dsh工作区运行游戏,存在沙盒阻挡)。每次改动前先备份,脚本重跑前先确认输入版本。
四、数据层(data)
4.1 覆盖层怎么来
以 0.98a-RC8 汉化版(黑体)的 data 为底,逐文件与0.98.5a-RC3 的 data 对照:文件名、表头、行数、id 集合。只把「98 有译文且 985 需要」的文件放进覆盖层,其余不碰。
03-数据层-CSV.py · 04-数据层-JSON.py · 05-数据层-Java.py
4.2 CSV 对齐
按id 列对齐,不按行号:985 会插入新行,行号会漂。对齐后逐列判断——整格搬(98 与 985 该列都非空且原文一致)或按单元格替换;id、键名、枚举值永远不译。
· rules.csv 约 1.2 万行,是最大的一块。
· descriptions、船体、武器、技能等表按同样规则处理。
· 每批改完跑 03b-校验CSV.py,核对列数、引号数、行数。
4.3 rules.csv 的三列
rules.csv 的文本不只在 text 列:options 列是对话选项,script列里还有 AddText、SetTooltip 这类调用里的句子。1a 阶段只搬了 script 列,options 列漏了 4,999 行,到 1f 才补齐(4,955行整格 + 3 处部分 + 40 行手工)。
· 搬任何一列之前,先把三列都过一遍。
· 选项 id序列要和 98 对得上,英文标签也要一致,才能整格搬。
4.4 编码与格式
· rules.csv 覆盖层必须是UTF-8 BOM + CRLF。
· 改完先验 CRLF 与引号数,再跑校验脚本。
· JSON 类文件单独用 04b-校验JSON.py。
五、jar 层
5.1 只动「被引用的字符串」
类文件的常量池里,CONSTANT_String(tag 8)指向一条 Utf8;同一条Utf8 也可能被类名、字段名、方法名或描述符共用。只替换被 String 常量引用的 Utf8,并且克隆一条新 Utf8 再改指向,原常量不动。这样不会碰到 JVM 元数据。
5.2 按位置搬(626 个类)
同一位置取三份 ldc 序列:98 英文、98 中文、985。逐位比对,满足「EN98[k] == 985[k] 且 ZH98[k] 是中文」才换。EN98 用的就是第一节里下载的 源\starfarer_obf.en.jar。
01-建对照表.py · 01b-建对照表-ldc.py · 08-按位置应用.py
5.3 兜底(873 个类)
位置对不上的类走兜底:只换被 String 常量引用的串,排除被类名 / 字段名 / 方法名/ 描述符共享的 Utf8。兜底只翻「看着像给人看的句子」,不碰短小的、像字段名的串。
79-api兜底v3.py · 61-第9步-api兜底v2.py
5.4 手工补丁
· 23-批次4-补丁.py:批次 4 的 3 条。
· 34-第7步-打补丁.py:1 个类、83 处。
· 技能效果行在 api jar 的skills/*.class 里,用 159-技能修复.py(13 类 25 条)与 161-技能修复2.py(5 类 9 条)按类限定替换。
· 125-回退SDR.py:把被误翻的ACA/ARC/VSDC insurgent activity 三条退回英文。
5.5 打包与校验
改完的类写回 jar,用 jar --create 或 Python 的zipfile 重写;重写后必须整包校验。
06b-校验jar.py:结构校验(常量池可解析、类数一致)
24-校验-非字符串常量.py:严格校验,约 12 分钟,期间不要让别的进程读 jar
jar 校验最容易踩的两个坑:zipfile 没 close 就 replace(Windows会报 WinError 5),以及校验时游戏或编辑器还占着 jar。
六、类二(985 新增)
6.1 分档
按出现频率分三档,只做甲、乙:
· 甲档(高频):开局选项、通用对话回复、短提示、api 新增文案。约 5 万字符。
· 乙档(中频):市场风味、酒吧事件、纯 script 提示、星系档案等,甲乙合计约 9 万字符。
· 丙档(长剧情):约 357 行、近 95 万字符,暂不排期。
清单与分批表在 产出\类二-清单.md,里面按 2甲-1~4、2乙-1~6 列了行数与字符数。
6.2 每批的固定流程
· 素材:93-类二细化.py 按 id 前缀与 text 长度分桶,导出待译清单。
· 译文:按批写进脚本,不要把译文写进临时文件再手工粘。
· 打补丁:整格替换或按 key 替换,写完立刻抽查。
· 校验:跑对应校验脚本,再抽 5 到 10 条对照原文。
· 记录:行数、字符数、改动文件写回清单。
6.3 翻译规范
· 人名、地名、船名保留拉丁原文;变量、占位符、%s、$heOrShe 这类不译。
· OR 之类的分隔符保留,别换成中文标点。
· 术语统一,先查已有译法再动笔;同一词在不同上下文可以有不同译法,但同一类界面要一致。
· 语气按角色:叙事文本正常译,娜迦台词按她的口吻。
· id、键名、枚举值、类名一律不译。
6.4 审核
· 54-校验api.py:3,688 条,核对元数据、非字符串常量。
· 翻短小的、像字段名的串之前,先跑 37-审计键用法.py 看它后面跟的是addPara 还是 JSONObject.has。
· 抽 5% 回读,确认没有把整句拆碎或误伤变量。
七、组装与测试
· 把 产出\data、产出\starfarer_obf.jar、产出\starfarer.api.jar复制到测试版目录,配 11 套字体与 cjkMode 配置,整包约 474 MB。
· 先启动器:能起来、模组列表正常。
· 再主菜单:语言、按钮、设置界面。
· 新开档:开局选项、对话、UI、提示。
· 读档:老档能读,界面无异常。
· 记录版本串与两个 jar 的 MD5,写回交接笔记。
八、已知的坑
· JVM 元数据(InnerClasses/ NestHost)被当成文本翻了:类文件损坏,启动直接崩。
· Object 被当 UI 词翻成「目标」:启动器NoSuchMethodError。
· 兜底只翻「含空格的句子」:Missions、Settings这类单词标签漏掉。
· TSV 双重转义、Windows 文件句柄没关:替换失败或损坏。
· 看着像标签、其实是数据键:sellprice mult 是 commodities.csv 的列名,翻了就读不到数据。
· rules.csv 的options 列漏搬:对话选项整片英文。
· 技能效果描述在 api jar 的skills/*.class:只改 skill_data.csv 不够。
· SDR 三条标签翻成中文后会被 SDR_CMD 当键用:必须退回英文。
· api 兜底曾把性格 id、类名附近的串翻掉:改前先跑 37 审计,改后跑 54 校验。
· 98 英文快照比正式发行版旧:按它逐行比 id 会把「985 有、快照没有」误算成新增,判断剩余量要看覆盖层里还残留的纯英文行。
九、回滚与备份
· 改动前备份对应文件;批量替换脚本一律先写临时文件再原子替换。
· jar 改坏:从 备份 恢复对应 jar,重跑该批补丁。
· data 改坏:覆盖层可整层重建,按文件恢复即可。
· 测试版目录:每次组装前先清空,避免旧文件残留。
十、给 DSH 会话的执行约定
如果这份文件交给 DSH 会话执行移植,按下面的约定来:
· 输入:本文件、工程根路径、0.98a-RC8 汉化版路径、0.98.5a-RC3 英文版路径、测试版路径。
· 本文件已经包含步骤、批次说明与验收标准,不需要额外的工程笔记;开工前先读第二、三节和「十一、批次编号说明」,用第一节确认两份游戏的版本。
· 文中的E:\SQ\小肥鲸管家\... 只是帖主的环境示例,按自己的工作区与安装位置替换,不要照抄。
· 所有写入只落在 产出;要改游戏目录时先复制到测试版,不原地改。
· 每批改动前后各跑一次对应校验,把结果写进报告。
· 遇到「不确定该不该翻」的串,停下来列清单问人,不要自行决定。
· 报告格式:批次号、改了哪些文件、行数或条数、校验结果、遗留问题。
十一、批次编号说明
这份文件里会出现 8a、1a、2甲-3 这样的编号,它们是实际工作时的批次代号,不是必须按顺序执行的步骤。这里一次讲清,别人接手时可以直接对照。
11.1 类一的批次
· 8a:物品、机制与名字。985 新增的物品与机制条目,命名和说法可以大量参考 98。
· 8b:行星与势力描述(descriptions.csv),33 条、约 3.1 万字符。同一条描述可能横跨 text1、text3、text4 几列,动手前先看列布局。
· 1a:rules.csv的 script 列,571 行。
· 1b:rules.csv里 98 与 985 原文有差异、但能参考旧译的行:75 行整格搬 + 56 处替换 + 1句台词。
· 1c:starfarer_obf.jar里可搬的串,87 处。
· 1d:starfarer.api.jar里可搬的串,321 处。
· 1e:Volturn相关的 4 条。
· 第 9 步:api jar 的搬运与兜底,两遍共 6,113 处、约 8.1 万汉字。
· 1f:rules.csv的 options 列补齐(4,955 行整格 + 3 处部分 + 40 行手工)。它属于类一的漏项,不属类二。
8a、8b 不叫 1x 的原因:它们原本是「第 8 步(985新增内容)」的两批,编号早于后来按「有无旧译」重分的类一/类二;重分后发现这两批能大量参考 98 的写法,就归进类一并沿用了原名,所以编号会跳。
11.2 类二的批次
· 2甲-1:开局与模式选项,10 行、406 字符。
· 2甲-2:通用对话回复,21 行、2,938 字符。
· 2甲-3:短提示,165 行、7,709 字符;实际分两批做,剧情向 88 行、DEV 菜单 77 行。
· 2甲-4:api 新增文案,718 条、39,718字符;先译 269 条完整句子,再处理 124 条标签与标题。
· 2乙-1:市场风味,4 行、2,362 字符。
· 2乙-2:酒吧事件,113 行、25,261 字符,分 a、b、c 三批。
· 2乙-3:纯 script 提示,59 行、9,046字符。
· 2乙-4:七星系档案,7 行、4,400 字符,分 a、b 两批。
· 乙-0 /乙-补:进入乙档之前的选项补齐与补充,合计 261 行选项,按 98 的 id 序列整格搬。
11.3 丙档与不做的部分
· 丙档:中段叙事 275 行、65,012 字符;长剧情82 行、48,060 字符;askoniaCrisis26,113 行、840,604 字符。合计 357 行、约 95 万字符,暂不处理。
· 98 自己没译的:229 行,不处理。
· 地名:1 行,保留原文。
11.4 编号怎么用
编号只用于指代批次,不代表执行顺序。实际推进是:先把类一(8a、8b、1a~1e、第 9 步)做完,再补 1f 的选项,然后做类二的甲档、乙-0/乙-补与乙档;丙档搁置。动手时按批次领活,不要按编号大小排序。
十二、当前进度(2026-11-13)
· 类一:全部完成(8a、8b、1a~1e、第 9 步 api jar),实机验证正常。
· 类二:甲档、1f 选项补齐、乙-0/乙-补、乙档全部完成。
· rules.csv 仍含英文的只剩 587 行:丙档 357、98 自己没译 229、地名 1。
· 丙档(约95 万字符)已定近期不处理;下一步是实机测试与收尾。
十三、致谢与署名
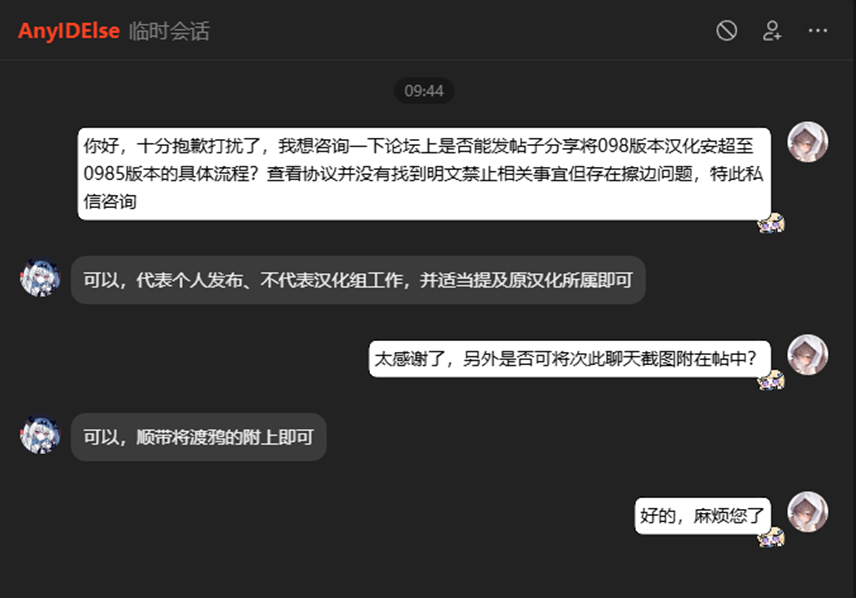
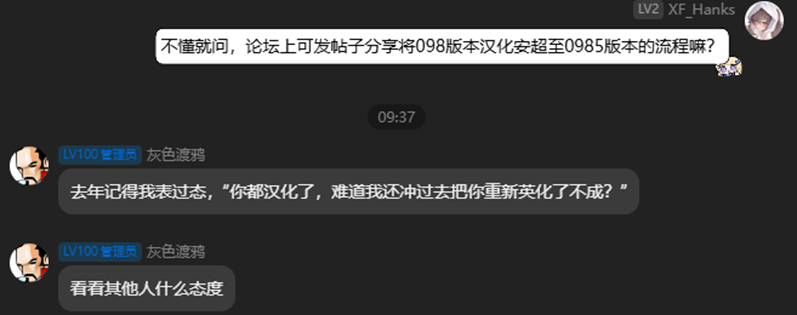
本指南由个人整理,不代表远星汉化组的工作。感谢远星汉化组成员 AnyIDElse 同意分享流程并允许附上聊天截图,感谢管理员灰色渡鸦的意见,也感谢汉化组多年来维护的简体中文汉化。
如果你按这份指南做出了自己的版本,请遵守相关协议与论坛规定,不发布不分享相关修改文件,仅可用于自用。


 发表于